01
Датасет голоса Sevil
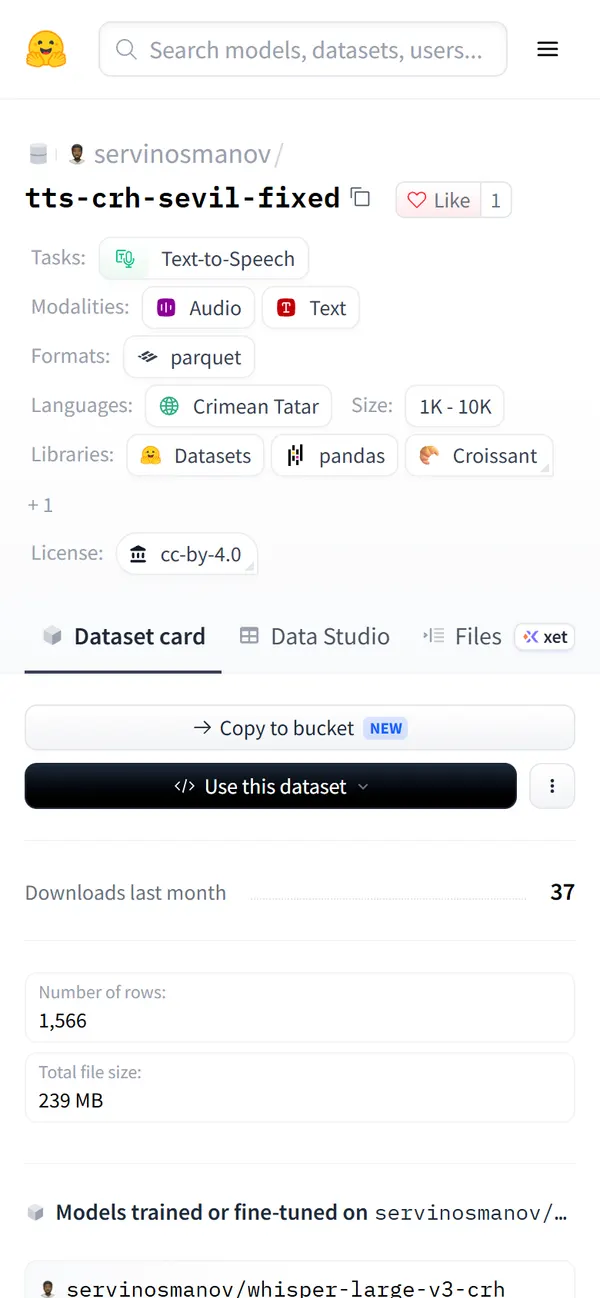
1 566 исправленных записей с текстом: обучающая, проверочная и тестовая части. Лицензия CC BY 4.0.
У больших сервисов этого языка почти нет. Здесь собирают живой голос и делают первые модели: одна читает текст вслух, другая записывает речь буквами.
У крупных голосовых сервисов крымскотатарского почти нет. Этот проект собирает живой голос и делает первые открытые модели: одна читает текст вслух, другая переводит речь в текст.
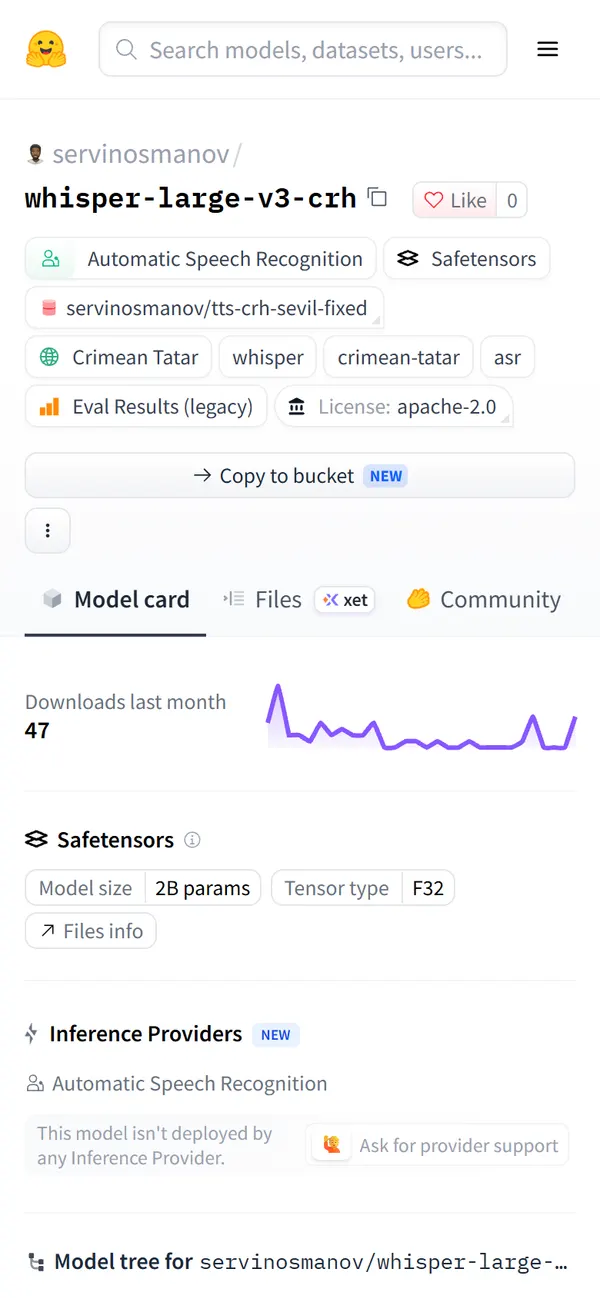
В основе — датасет из 1 566 записей голоса Севиль, примерно 2,6 часа речи. В исходном наборе рабочими были только 415 файлов, теперь исправлены все: шум, громкость, паузы и тексты. На этих записях дообучены SpeechT5 (синтез речи) и Whisper Large v3 (распознавание, ошибка в словах — 13,7 %).
Синтезированным голосом уже начитан целый роман — «Merdiven» Шамиля Алядина, 16 глав, почти два часа. Все модели и данные открыты (CC BY 4.0 и Apache 2.0): их можно встроить в свои приложения.
Датасет исправленных записей голоса.
Первая модель, которая читает текст вслух.
Первая модель, которая записывает речь буквами.
1 566 исправленных записей с текстом: обучающая, проверочная и тестовая части. Лицензия CC BY 4.0.
Whisper Large v3, дообученный на крымскотатарском. Понимает кириллицу и латиницу, ошибка в словах — 13,7 %.
Кто делает: Сервин Османов (Ana Yurt).
Нашли ошибку? Напишите — поправим в следующем обновлении.
selam@ocaq.ru