01
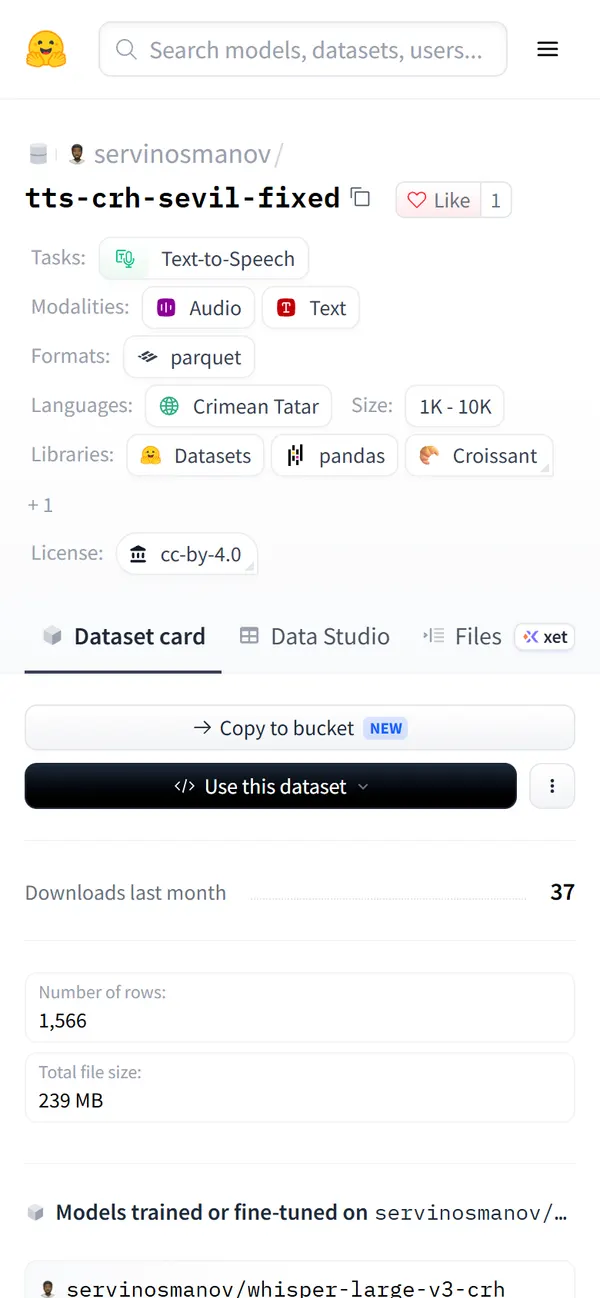
Sevil ses veri seti
Metinleriyle 1.566 düzeltilmiş kayıt: eğitim, doğrulama ve test bölümleri. Lisans: CC BY 4.0.
Büyük servislerde bu dil neredeyse yok. Burada canlı ses toplanıyor ve ilk modeller yapılıyor: biri metni sesli okuyor, diğeri konuşmayı yazıya döküyor.
Büyük ses servislerinde Kırım Tatarcası neredeyse yok. Bu proje canlı ses topluyor ve ilk açık modelleri yapıyor: biri metni sesli okuyor, diğeri konuşmayı metne çeviriyor.
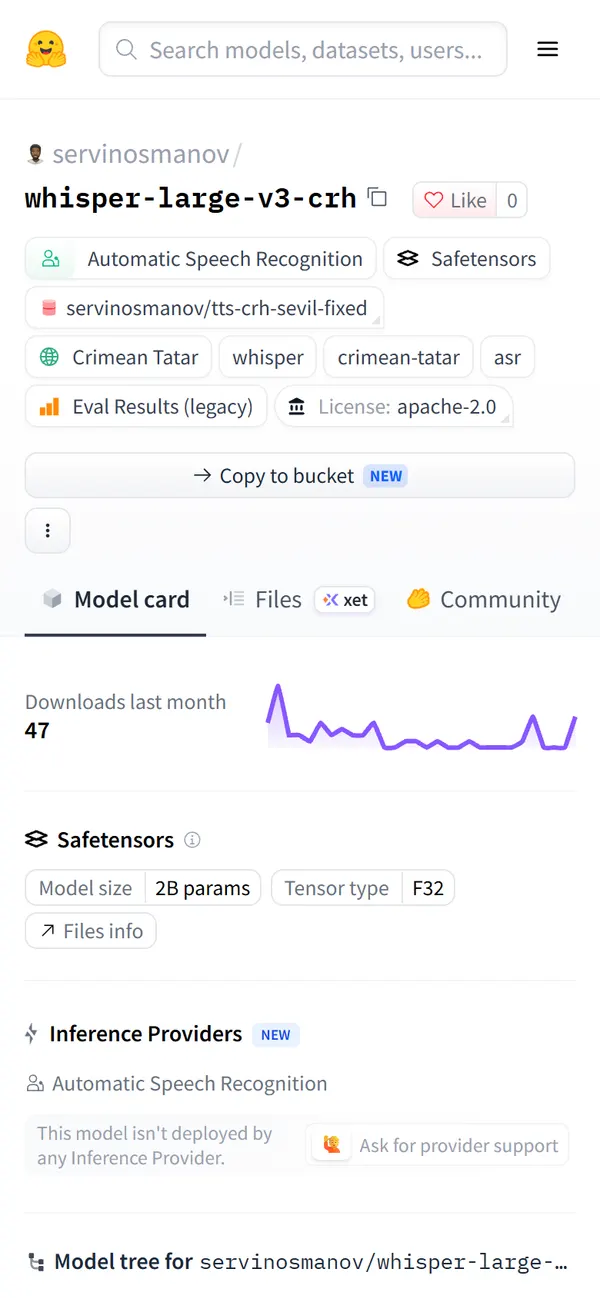
Temelinde Sevil’in sesinden 1.566 kayıtlık bir veri seti var, yaklaşık 2,6 saatlik konuşma. Orijinal sette yalnızca 415 dosya kullanılabiliyordu, şimdi hepsi düzeltildi: gürültü, ses seviyesi, duraklamalar ve metinler. Bu kayıtlarla SpeechT5 (metin okuma) ve Whisper Large v3 (konuşma tanıma, kelime hata oranı %13,7) ince ayarlandı.
Sentezlenmiş sesle bir roman baştan sona okundu bile: Şamil Alâdin’in “Merdiven” romanı, 16 bölüm, yaklaşık iki saat. Bütün modeller ve veriler açık (CC BY 4.0 ve Apache 2.0): kendi uygulamalarınıza ekleyebilirsiniz.
Düzeltilmiş ses kayıtlarından veri seti.
Metni sesli okuyan ilk model.
Konuşmayı yazıya döken ilk model.
Metinleriyle 1.566 düzeltilmiş kayıt: eğitim, doğrulama ve test bölümleri. Lisans: CC BY 4.0.
Kırım Tatarcasıyla ince ayarlanmış Whisper Large v3. Kiril ve Latin harflerini anlıyor, kelime hata oranı %13,7.
Kim yapıyor: Servin Osmanov (Ana Yurt).
Bir hata mı buldunuz? Yazın, bir sonraki güncellemede düzeltelim.
selam@ocaq.ru